Sie haben Jahre an Rechnungen als gewöhnliche PDFs, und nun verlangt ein Kunde eine strukturierte E-Rechnung. Die naheliegende Frage lautet, ob sich das Vorhandene nicht einfach umwandeln lässt. Die ehrliche Antwort hat zwei Hälften: der technische Teil ist unkompliziert — und der Teil, der darüber entscheidet, ob das Ergebnis verlässlich ist, ist es nicht.
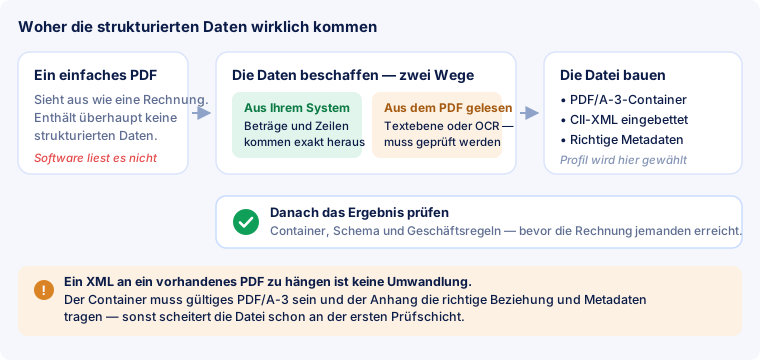
Der Unterschied ist wichtig, weil das Wort „umwandeln“ einen Schritt verdeckt. Ein gewöhnliches PDF enthält überhaupt keine strukturierten Daten. Optisch mag es von einer echten ZUGFeRD-Datei nicht zu unterscheiden sein, aber es gibt keine eingebettete XML, die Software lesen könnte. Umwandeln bedeutet deshalb zweierlei: die Rechnungsdaten zu beschaffen und anschließend eine korrekte Datei mit diesen Daten im Inneren zu bauen.
Schritt 1 — woher die Daten kommen
Es gibt zwei Wege, und sie sind nicht gleich verlässlich.
Aus dem System, das die Rechnung erzeugt hat
Wurde das PDF von einer Buchhaltungs- oder Rechnungssoftware erzeugt, liegen dort die zugrunde liegenden Zahlen weiterhin vor: Beträge, Steuersätze, Positionen, Datumsangaben, Kennungen. Diese Zahlen in den Generator zu geben ist der verlässliche Weg, weil nichts geraten werden muss — die Daten sind bereits exakt und bereits strukturiert.
Darauf zu bestehen lohnt sich auch dann, wenn es nach mehr Aufwand aussieht. Zahlen aus einer gerenderten Seite zurückzugewinnen heißt, etwas zu rekonstruieren, das an anderer Stelle längst in exakter Form existiert.
Die Daten aus dem PDF auslesen
Wenn nur das PDF existiert — eine Lieferantenrechnung, ein Archiv, ein Dokument aus einem System, das Sie nicht mehr betreiben — müssen die Daten aus der Datei selbst gewonnen werden. Zwei Fälle:
- Das PDF hat eine Textebene. Die meisten software-erzeugten PDFs haben sie. Der Text lässt sich direkt lesen, und die eigentliche Arbeit steckt im Layout: welche Zahl ist der Nettobetrag, welche die Steuer, welche Zeilen gehören zur Tabelle.
- Das PDF ist ein Scan. Eine abfotografierte oder eingescannte Rechnung ist nur ein Bild; die Zeichen müssen erst erkannt (OCR) und dann gedeutet werden. Jeder Erkennungsfehler wird flussabwärts zu einer falschen Zahl.
Dieser Schritt braucht einen Menschen. Layoutbasierte Extraktion aus einer beliebigen Rechnung ist heute noch nicht so weit, dass man ihr bei den Zahlen vertrauen könnte, auf die es ankommt — Steuerbeträge, Endsummen, Kennungen. Jeder ernsthafte Ablauf legt die ausgelesenen Werte einem Menschen zur Bestätigung vor, bevor die Datei gebaut wird. Ein Konverter, der aus jedem beliebigen PDF in dreißig Sekunden eine fertige E-Rechnung verspricht, ohne dass etwas zu prüfen wäre, verspricht etwas, das der Stand der Technik nicht hergibt.
Schritt 2 — die Datei bauen
Sind die Daten bestätigt, müssen sie in einen PDF/A-3-Container eingebettet werden. Hier scheitern viele Eigenbau-Versuche, denn eine XML-Datei im Editor an ein PDF anzuhängen ist nicht dasselbe.
Eine korrekte hybride Datei verlangt:
- Einen gültigen PDF/A-3-Container — die Archivvariante des PDF, mit eingebetteten Schriften und deklarierten Farbprofilen.
- Die XML mit der richtigen Beziehung angehängt (
AFRelationship) und unter dem erwarteten Dateinamen, damit empfangende Software sie als Rechnungsdaten erkennt und nicht als beliebigen Anhang. - XMP-Metadaten, die angeben, welchem Standard und welchem Profil die Datei zu folgen behauptet.
- Ein Profil, das zu den tatsächlich vorhandenen Daten passt. Das Profil EN 16931 zu behaupten und Felder wegzulassen, die es verlangt, ergibt eine Datei, die bei der Prüfung durchfällt; siehe Profile.
Und was ist mit PDF24, Adobe Acrobat, DATEV oder Lexware?
Diese Frage kommt ständig, deshalb die klare Antwort.
- Allgemeine PDF-Werkzeuge — Acrobat, PDF24 und ähnliche — können eine Datei an ein PDF anhängen und oft auch PDF/A erzeugen. Was sie nicht können: aus Ihrer Rechnung eine gültige CII-Rechnungs-XML bauen, denn sie wissen nicht, was eine Rechnung ist. Eine selbst gebastelte XML anzuhängen ergibt eine Datei, die schon an der ersten Prüfschicht scheitert.
- Buchhaltungs- und Rechnungssoftware — DATEV, Lexware und ihre Wettbewerber — erzeugt zunehmend direkt ZUGFeRD, und wenn Ihre Rechnungen dort entstehen, ist das mit Abstand der beste Weg: die Daten verlassen ihre strukturierte Form nie. Was diese Systeme in der Regel nicht anbieten, ist die Umwandlung eines beliebigen fremden PDFs, das nicht von ihnen stammt.
- Spezialisierte Konverter liegen dazwischen: sie lesen das PDF, schlagen die Daten vor und bauen die hybride Datei. Ihre Schwachstelle ist immer der Leseschritt — weshalb der Bestätigungsschritt wichtiger ist als die Geschwindigkeit.
Müssen Sie Ihr Archiv überhaupt umwandeln?
Meistens nicht — und das erspart eine Menge sinnloser Arbeit.
In Deutschland ist der Empfang strukturierter Rechnungen seit dem 1. Januar 2025 Pflicht; das Ausstellen wird ab dem 1. Januar 2027 für Unternehmen mit mehr als 800.000 Euro Vorjahresumsatz verpflichtend und ab dem 1. Januar 2028 für alle übrigen. Kleinbetragsrechnungen bis 250 Euro brutto und Umsätze an Verbraucher sind ausgenommen, Kleinunternehmer bleiben von der Ausstellungspflicht dauerhaft befreit.
Nichts davon gilt rückwirkend für bereits ausgestellte Rechnungen. Sie bleiben in der Form gültig, in der sie ausgestellt wurden, und müssen in dieser Form aufbewahrt werden. Ein Altarchiv nach ZUGFeRD umzuwandeln ist deshalb ein optionales und meist überflüssiges Projekt. Worauf es ankommt: dass Rechnungen, die Sie ab jetzt ausstellen, von vornherein als strukturierte Dokumente entstehen.
Die Fälle, in denen das Umwandeln vorhandener PDFs wirklich hilft, sind enger: ein Kunde, der auch für bereits versandte Dokumente nur strukturierte Rechnungen annimmt, ein Systemwechsel, oder eine eingegangene Lieferantenrechnung, die Sie automatisch verbuchen wollen.
Das Ergebnis immer prüfen
Eine umgewandelte Datei sollte nie ungeprüft hinausgehen. Beim Umwandeln kann mehr schiefgehen als beim Erzeugen von Grund auf, weil die Daten einen Deutungsschritt durchlaufen haben. Lassen Sie die fertige Datei durch einen Validator laufen und sehen Sie sich alle drei Schichten an — Container, Schema und Geschäftsregeln —, bevor sie jemanden erreicht. Wie das funktioniert, steht unter wie die Prüfung funktioniert.
Zwei Fehler treten nach dem Umwandeln besonders häufig auf:
- Summen, die nicht aufgehen — Rundungsdifferenzen zwischen Positionssummen und Gesamtbetrag, gemeldet als
BR-CO-*-Codes. - Eine Steuerkategorie ohne die verlangte Begründung — etwa eine steuerbefreite Rechnung oder ein Reverse-Charge-Fall ohne angegebenen Grund.
Beide stammen aus dem Extraktionsschritt, nicht aus dem Dateiformat — genau dafür gibt es den Bestätigungsschritt. Was diese Codes zusichern, steht unter Geschäftsregeln.
Was Sie vorher zusammentragen müssen
Eine strukturierte Rechnung verlangt Angaben, die auf einer gewöhnlichen PDF-Rechnung nicht immer stehen. Bevor Sie anfangen, klären Sie diese Liste — fehlt eine Angabe, hilft kein Werkzeug, sie muss beschafft werden.
| Angabe | Feld | Steht auf einer normalen Rechnung? |
|---|---|---|
| Rechnungsnummer, -datum, Währung | BT-1, BT-2, BT-5 | immer |
| Name und Anschrift des Verkäufers, Länderkennzeichen | BT-27, BG-5, BT-40 | fast immer — das Länderkennzeichen oft nicht als Code |
| Name des Käufers | BT-44 | immer |
| USt-IdNr. oder Steuernummer des Verkäufers | BT-31 / BT-32 | meistens, aber häufig ohne Länderkennzeichen |
| Positionen mit Menge, Einzelpreis, Nettobetrag | BG-25 | ja, aber als Tabellenbild |
| Steuersatz und Steuerbetrag je Satz | BT-119, BT-117 | meistens nur als Summe, nicht je Kategorie |
| Zahlungsangaben, IBAN | BG-16, BT-84 | meistens — mit Leerzeichen gedruckt |
| Referenz des Käufers, bei Behörden die Leitweg-ID | BT-10 | selten — muss beim Empfänger erfragt werden |
| Ansprechpartner, Telefon, E-Mail des Verkäufers | BG-6 | selten vollständig |
| Begründung bei Steuerbefreiung oder Reverse-Charge | BT-120 / BT-121 | als Satz im Fließtext, nicht als Feld |
Die letzten drei Zeilen sind der übliche Grund, aus dem eine sonst tadellose Umwandlung scheitert: Die Angaben existieren im Geschäftsvorgang, aber nicht auf dem Blatt.
Schritt für Schritt
- Herkunft klären. Gibt es das Programm noch, das diese Rechnung erzeugt hat? Wenn ja, exportieren Sie die Daten von dort und überspringen Sie das Auslesen ganz. Das ist kein Umweg, sondern die Abkürzung.
- Prüfen, ob eine Textebene da ist. Markieren Sie im PDF-Reader einen Betrag mit der Maus. Lässt er sich markieren und kopieren, ist Text vorhanden. Springt die Auswahl über die ganze Seite, ist es ein Bild — dann ist es ein Scan, und der Weg wird länger.
- Daten auslesen und zuordnen. Aus den erkannten Zeichen werden Felder. Das ist der Schritt, in dem Fehler entstehen; der Abschnitt unten zeigt an einem Beispiel, wo genau.
- Fehlendes ergänzen. Leitweg-ID, Kontaktangaben, Befreiungsgrund — siehe die Liste oben. Nichts davon lässt sich erraten.
- Datei bauen. Profil wählen (im Regelfall EN 16931), XML erzeugen, als Anhang in ein PDF/A-3 legen. Dieser Schritt ist reine Mechanik und geht selten schief.
- Prüfen und erst dann versenden. Container, Schema, Geschäftsregeln. Danach die Zahlen im Bericht mit denen auf der Seite vergleichen — die Prüfung sagt nichts darüber, ob 850,00 auch wirklich der richtige Betrag war.
Die Schritte 1 bis 4 kosten die Zeit. Schritt 5 dauert Sekunden, und Schritt 6 ist der einzige, der Ihnen sagt, ob die vorherigen gestimmt haben.
Ein durchgerechnetes Beispiel
Theorie hilft hier wenig, deshalb einmal der ganze Weg an einer Rechnung. Das PDF hat eine Textebene, es ist also der gute Fall — kein Scan, keine Zeichenerkennung. Was ein Textextraktor aus der Seite herausholt, sieht ungefähr so aus:
| Zeile aus der Textebene |
|---|
Muster Werkzeug GmbH · Industriestr. 4 · 45127 Essen |
Rechnung Nr. 2026-0417 Kundennummer 88213 |
Rechnungsdatum 04.09.2026 Lieferdatum 01.09.2026 |
3 Spannzange SZ-12 249,00 747,00 |
1 Adapterplatte A-4 120,50 120,50 |
Rabatt 2 % -17,50 |
Nettobetrag 850,00 |
zzgl. 19 % USt 161,50 |
Rechnungsbetrag 1.011,50 |
USt-IdNr. DE812345678 IBAN DE89370400440532013000 |
Ein Mensch liest das in zwei Sekunden. Für ein Programm sind es bloß Zeichen mit Koordinaten, und daraus muss eine Zuordnung zu den Feldern der Norm werden:
| Feld | Wert | Woran es hängt |
|---|---|---|
BT-1 Rechnungsnummer | 2026-0417 | steht in derselben Zeile wie die Kundennummer — die Verwechslung ist der häufigste Fehlgriff überhaupt |
BT-2 Rechnungsdatum | 2026-09-04 | im PDF deutsches Format, in der XML ISO — 04.09.2026 wird zu 2026-09-04 |
BT-27 Verkäufer | Muster Werkzeug GmbH | erste Zeile der Kopfleiste, aber nur wenn dort nicht das Logo als Bild steht |
BT-31 USt-IdNr. | DE812345678 | eindeutig erkennbar, daher zuverlässig |
BT-131 Positionen | 747,00 und 120,50 | die Tabelle muss als Tabelle erkannt werden, nicht als Textblock |
BT-107 Nachlass | 17,50 | ein Minuszeichen davor; wird es übersehen, addiert sich der Rabatt |
BT-109 netto | 850,00 | — |
BT-117 Steuer | 161,50 | der Satz 19 steckt im selben Textstück wie der Betrag |
BT-112 brutto | 1011,50 | der Tausenderpunkt muss weg — 1.011,50 als Zahl gelesen ergibt sonst 1,01 |
BT-84 IBAN | DE89370400440532013000 | im PDF oft mit Leerzeichen gedruckt, in die XML gehört sie ohne |
Vier Stellen in dieser einen Rechnung sind heikel, und keine davon ist exotisch: die Rechnungsnummer neben der Kundennummer, das Datumsformat, der Tausenderpunkt und das Vorzeichen des Rabatts. Genau deshalb steht am Ende dieses Wegs eine Sichtprüfung durch einen Menschen und keine Automatik.
Stimmt die Zuordnung, ergibt sich der Rest von selbst: 747,00 + 120,50 = 867,50, minus 17,50 sind 850,00, plus 19 % sind 1011,50. Das sind dieselben Ketten, die die Geschäftsregeln nachrechnen.
Sonderfall: die Rechnung ist ein Scan
Bei einem eingescannten oder abfotografierten Beleg gibt es keine Textebene — es gibt ein Bild. Zwischen Bild und Feldern liegt die Zeichenerkennung, und sie verhält sich anders als ein Fehler, den man bemerkt: Sie liefert kein leeres Feld, sondern ein falsches. Aus einer 8 wird eine 3, aus 1.011,50 wird 1.011,5D, aus einem O eine 0.
Drei Dinge machen den Unterschied zwischen brauchbar und gefährlich:
- Auflösung. Unter 300 dpi wird aus Zeichenerkennung Raten. Ein Foto vom Bildschirm ist für diesen Zweck unbrauchbar.
- Gerade Seite. Schräg eingezogene Blätter verschieben Spalten gegeneinander, und die Zuordnung „diese Zahl gehört in diese Spalte“ bricht als Erstes.
- Nachkontrolle jeder Zahl. Nicht stichprobenartig. Summen, Steuerbeträge, Kennungen und die Rechnungsnummer werden einzeln gegen die Seite gelesen.
Wenn der Beleg von einem Lieferanten kommt, ist der kürzere Weg fast immer, ihn um die strukturierte Datei zu bitten, statt sie aus seinem Papier zu rekonstruieren. Ab 2025 muss er sie ohnehin empfangen können, und in aller Regel kann sein Programm sie auch ausstellen.
Typische Fehler und die Meldungen, die sie auslösen
Beim Umwandeln entstehen immer wieder dieselben Fehler, und weil die Prüfung sie mit einem Regelcode quittiert, lässt sich vom Code auf die Ursache zurückschließen.
| Was schiefgeht | Meldung | Abhilfe |
|---|---|---|
| Tausenderpunkt mitgelesen, Bruttobetrag landet als 1,01 in der Datei | BR-CO-15 | Trennzeichen vor der Umwandlung entfernen, nicht danach |
| Rabatt ohne Minuszeichen übernommen | BR-CO-13 | Nachlass gehört mit positivem Betrag in BT-107, nicht als negative Position |
| Positionssummen aus Menge × Preis neu gerechnet statt übernommen | BR-CO-10 | die im PDF gedruckte Positionssumme übernehmen — sie ist die verbindliche |
| Steuerbetrag gerundet, Bemessungsgrundlage nicht | BR-CO-17 | beide Werte auf zwei Stellen, kaufmännisch |
| USt-IdNr. ohne Länderkennzeichen aus den Stammdaten | BR-CO-09 | DE voranstellen, Leerzeichen entfernen |
| Steuernummer statt USt-IdNr. gefunden, beide Felder bleiben leer | BR-CO-26 | die Steuernummer in BT-32 schreiben, nicht verwerfen |
| IBAN mit Leerzeichen übernommen | BR-DE-19 | Trennzeichen entfernen |
| Positionstabelle nicht erkannt, nur Summen übertragen | BR-16 | lieber eine Sammelposition über den Gesamtbetrag als gar keine |
Eine Meldung, die kein Fehler ist. Auf jeder umgewandelten ZUGFeRD-Datei erscheint BR-DE-21. Sie besagt nur, dass die Datei keine XRechnung ist — was zutrifft und beabsichtigt ist.
Häufige Fragen
Kann ich einen Scan umwandeln?
Technisch ja, verlässlich nein. Ein Scan ist ein Bild; die Zeichen müssen erst erkannt werden, und jeder Erkennungsfehler wird zu einer falschen Zahl in einem Feld, auf das es ankommt. Wenn es sich nicht vermeiden lässt, prüfen Sie jede Zahl von Hand nach — vor allem Summen und Kennungen.
Kann ich mein ganzes Archiv auf einmal umwandeln?
Sie können, aber Sie müssen fast nie. Die Pflicht betrifft Rechnungen, die Sie ab dem Stichtag ausstellen, nicht Ihr Archiv. Alte Rechnungen bleiben als PDF gültig und aufbewahrungsfähig. Sinnvoll ist eine Umwandlung nur, wenn ein Empfänger eine bestimmte alte Rechnung nachträglich strukturiert haben möchte.
Bleibt das Aussehen der Rechnung erhalten?
Ja. Bei einer hybriden Rechnung bleibt die sichtbare Seite unverändert — die XML wird ihr als Anhang beigelegt, nicht an ihre Stelle gesetzt. Wer die Datei im PDF-Reader öffnet, sieht dasselbe wie vorher.
Was, wenn im PDF eine Angabe fehlt, die die Norm verlangt?
Dann kann sie auch nicht herausgelesen werden, und sie muss ergänzt werden. Am häufigsten fehlen die Leitweg-ID beim öffentlichen Auftraggeber (BR-DE-15) und die Kontaktangaben des Verkäufers (BR-DE-2). Beides steht auf einer gewöhnlichen Rechnung selten vollständig.
Welches Profil soll ich wählen?
Für den Regelfall EN 16931 — das ist das Profil, das der Norm entspricht und das Empfänger erwarten. BASIC reicht für einfache Rechnungen ohne Besonderheiten, EXTENDED brauchen Sie nur bei Sachverhalten, die die Norm nicht abdeckt. Die Unterschiede stehen unter Profile.
Woran erkenne ich, dass die Umwandlung gelungen ist?
Nicht daran, dass sich die Datei öffnen lässt. Laden Sie sie in eine Prüfung und sehen Sie sich den Bericht an: Container, Schema und Geschäftsregeln müssen bestehen. Danach vergleichen Sie die Zahlen im Bericht mit denen auf der Seite — die Prüfung bestätigt Konformität, nicht Richtigkeit.
Kurz zusammengefasst
- Umwandeln heißt Daten beschaffen und Datei bauen. Der zweite Schritt ist trivial, der erste entscheidet über das Ergebnis.
- Aus dem System ist besser als aus dem PDF. Existieren die Zahlen noch irgendwo strukturiert, nehmen Sie sie von dort.
- Textebene ja, Scan nur mit Nachkontrolle. Zeichenerkennung erzeugt falsche Zahlen, nicht leere Felder — und falsche Zahlen fallen nicht auf.
- Vier Stolperstellen decken die meisten Fehler ab: Rechnungsnummer neben Kundennummer, Datumsformat, Tausendertrennzeichen, Vorzeichen des Rabatts.
- Immer prüfen, bevor Sie versenden — und den Regelcode aus dem Bericht im Codeverzeichnis nachschlagen, statt zu raten.
- Das Archiv muss nicht umgewandelt werden. Die Pflicht gilt für neue Rechnungen.
Was man ehrlicherweise erwarten kann
Vollautomatisches Umwandeln — beliebiges PDF hochladen, geprüfte hybride Datei zurückbekommen, nichts kontrollieren — ist ein aktives Entwicklungsfeld und hängt daran, dass die Datenextraktion verlässlich genug wird, um ihr Steuerzahlen anzuvertrauen. Für beliebige Layouts ist sie das noch nicht, und wer etwas anderes behauptet, verkauft die Vorführung statt des Normalfalls.
Der Weg, der heute funktioniert, ist unspektakulär und verlässlich: die Daten dort nehmen, wo sie entstanden sind, wo das nicht geht einmal bestätigen, den Generator PDF/A-3 und XML bauen lassen — und vor dem Versand prüfen.